Документы и OCR
Данные категории
- Инструментов в категории
- 7
- С бесплатным тарифом
- 5
- Медианная цена
- 8 $/мес по 3 сервисам
Кого выбрать
Рассчитано по полноте проверенных сведений, тарифам и голосам посетителей
- Самые полные сведения Syntolk
- С бесплатным тарифом AI Image Translator
- Цена не выше медианной Pixno

 Syntolk ▲ 2 ▼ 0
Платформа для анализа документов и сверки данных в форматах PDF, DOCX и XLSX. Помогает юристам, аудиторам и финансистам быстро находить противоречия и проверять договоры, подтверждая каждый ответ точными цитатами со ссылками на первоисточник.

 AI Image Translator ▲ 1 ▼ 0
Автоматически переводит текст на изображениях прямо в браузере, стирая оригинальные надписи, восстанавливая фон и сохраняя исходный стиль шрифтов. Инструмент подходит для локализации комиксов, баннеров и инструкций более чем на 200 языков без работы в графических редакторах.
 Pixno ▲ 0 ▼ 0
Превращает снимки досок, презентации, документы и аудиозаписи в аккуратные конспекты с выжимками, формулами и таблицами. Отличная штука для учебы и личных баз знаний с прямым экспортом в Notion, Obsidian и офисные редакторы.

 Lido ▲ 0 ▼ 0
Вытаскивает данные из любых PDF-файлов, кривых фоток и рукописных сканов прямо в Excel, Google Sheets или CSV. Сервис понимает суть документов без жестких шаблонов и разметки, а настраивается простыми текстовыми промптами.
 LensUp ▲ 2 ▼ 0
Браузерный набор инструментов для сканирования документов с камеры, редактирования PDF, сжатия файлов под точный лимит в килобайтах и конвертации в Markdown. Вся обработка снимков и распознавание текста на 21 языке выполняются локально на устройстве без отправки файлов на сервер.
 NeiroTender ▲ 1 ▼ 0
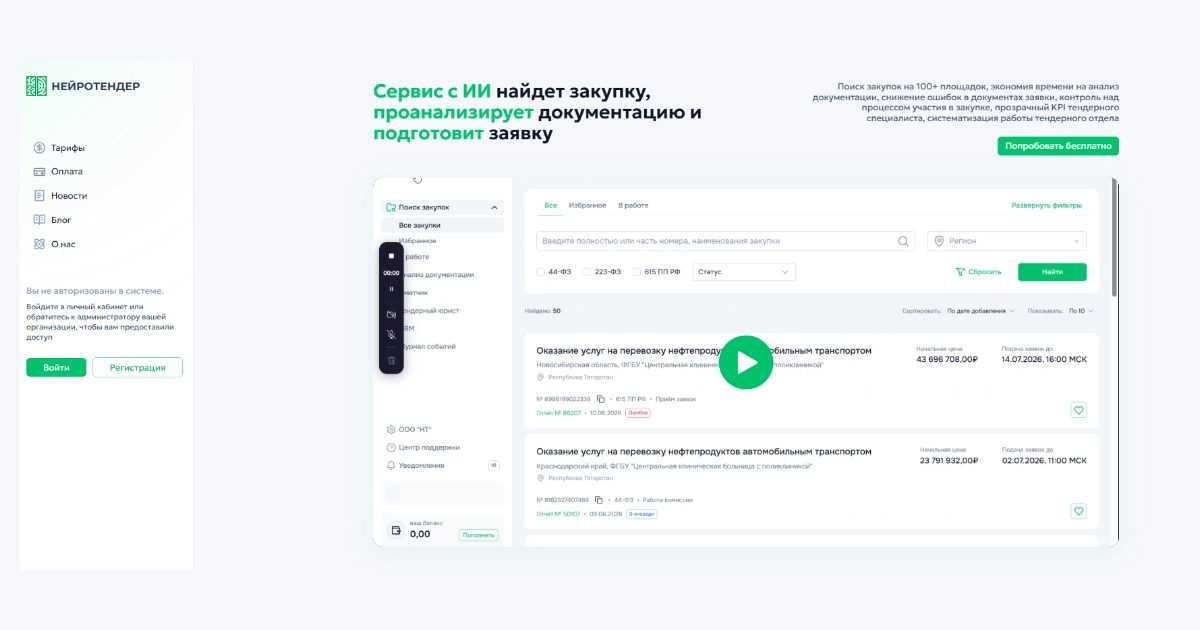
Платформа со встроенной CRM снимает с бизнеса и тендерных специалистов головную боль при работе с закупками по 44-ФЗ, 223-ФЗ и 615-ПП. Сервис сам ищет извещения, выцепляет юридические риски в документации и собирает пакет документов для подачи заявки.
 Pdftranslator AI ▲ 1 ▼ 0
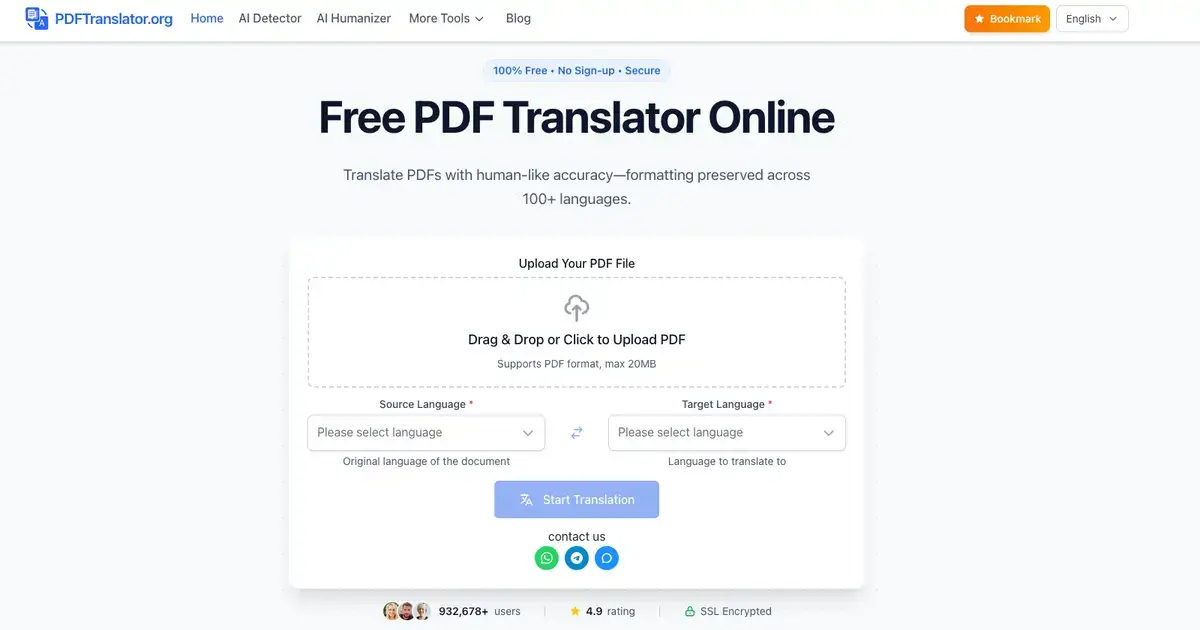
Сервис переводит PDF-документы более чем на 100 языков с полным сохранением исходной верстки, таблиц и формул. Встроенный модуль OCR распознает и переводит текст на сканах и изображениях прямо в границах исходного макета.
Сравнение сервисов
| Сервис | Модель | Цена от | Бесплатный тариф | Голоса |
|---|---|---|---|---|
| Syntolk | Платно | от 990 ₽/мес | Нет | ▲ 2 ▼ 0 |
| AI Image Translator | Фримиум | от 7,90 $ | Есть | ▲ 1 ▼ 0 |
| Pixno | Фримиум | от 5 $/мес | Есть | ▲ 0 ▼ 0 |
| Lido | Фримиум | от 36 $/мес | Есть | ▲ 0 ▼ 0 |
| LensUp | Фримиум | от 8 $/мес | Есть | ▲ 2 ▼ 0 |
| NeiroTender | Платно | от 3 900 ₽/мес | Нет | ▲ 1 ▼ 0 |
| Pdftranslator AI | Бесплатно | Бесплатно | Есть | ▲ 1 ▼ 0 |
Частые вопросы
Чем ИИ-инструменты для документов отличаются от стандартного OCR?
Стандартный OCR лишь сопоставляет очертания букв со шрифтовой базой и часто теряет структуру текста при нестандартном форматировании. ИИ-решения анализируют контекст и макет документа целиком: они сохраняют взаимосвязи колонок, понимают смысл полей в бланках и могут извлекать конкретные данные (например, общую сумму из чека), даже если документ замят или повернут.
Справляются ли нейросети с рукописным текстом и сложными таблицами?
Печатный текст распознается с точностью до 99%, но рукописный ввод требует специализированных моделей и четкого разрешения исходного файла. Таблицы со скрытыми границами или объединенными ячейками требуют продвинутого анализа макета (Layout Analysis), поэтому на сложных массивах данных перед экспортом рекомендуется проверять разметку сетки.
Доступны ли эти инструменты бесплатно?
Большинство сервисов предлагают ознакомительный объем — как правило, от 10 до 100 страниц в месяц с ограничением размера одного файла. Расширенные возможности, такие как пакетная обработка сотен документов, распознавание через API и интеграция с корпоративными базами данных, доступны только на платных тарифах.
Безопасно ли загружать в облачные ИИ-сервисы конфиденциальные документы?
Безопасность зависит от политики конфиденциальности конкретной платформы. Для обработки юридических и финансовых файлов необходимо выбирать сервисы, гарантирующие сквозное шифрование, запрет на использование клиентских данных для обучения общих нейросетей, автоматическое удаление файлов с сервера или возможность локального развертывания (on-premise).
Подборки по этой теме
Другие категории
Об этой категории
Для вычислительной системы графический скан квитанции или фотография договора — это лишь неупорядоченный массив цветовых координат. Классическое оптическое распознавание (OCR) решает задачу нижнего уровня: транслирует геометрические контуры символов в машиночитаемый текст. Однако современные нейросетевые инструменты работают на уровне семантического анализа. Они оценивают топологию документа, распознают иерархию заголовков, привязку подписей и взаимосвязи в табличных сетках, избавляя специалистов от монотонного ручного переноса данных в базы учета.
Ключевая функция категории — трансформация неструктурированных файлов в упорядоченные наборы данных. Если алгоритм встречает многостраничный отчет, он может сгенерировать его краткую выжимку по заданным критериям или автоматически замаскировать персональные данные. Сервисы способны извлекать ключевые сущности — суммы, даты, реквизиты контрагентов — и распределять их по соответствующим полям таблиц или передавать дальше по цепочке автоматизации через API.
При выборе инструмента первостепенное значение имеет тип входящей информации. Для стандартизированных печатных форм достаточно базовых моделей распознавания. Если же в процессах задействованы рукописные заметки, сканы с дефектами сжатия или комплексные финансовые отчеты, критическими факторами становятся качество предобработки изображений, точность распознавания нестандартной верстки и соответствие платформы стандартам конфиденциальности.